Weaver:在实践中长出来的 AI 自进化系统
作为一个穷学生,已经重度使用 geminicli 三个月了,在惊叹于 gemini 的智商之余,笔者也常被它的健忘和幻觉所困扰。
这种痛苦是极其具体的:当你正在为一个大项目的复杂泛型逻辑头秃时,你明明在第一轮对话就交代过“所有类型定义必须使用 interface”,但在第 30 轮,它却随手写了一堆 type;或者它言之凿凿地报告说“代码已修改成功”,但当你打开文件一看,物理内容却纹丝不动。不断重复地提示它相同的错误,或者在大项目的情况下,它经常罔顾事实乱改代码,这些确实让人头痛。
最近 openclaw 爆火,我也去体验了一下,确实好玩,但感觉它似乎还不太能作为一个称手的工具来进行科研或开发。不过群众的智慧是无穷的,在浏览 clawhub 的过程中,我看到了许多让人眼前一亮的 skill(技能)。受到其中 self-evolment(自我演进) 思路的启发,我在 geminicli 的扩展库里转了一圈,发现还没有类似的插件,便一拍脑袋,决定自己开发一个扩展,看看能不能对平常的使用有所帮助。这也是我在 ReAct 系统(推理与行动循环)里的第一次尝试。个人使用下来感觉还可以,记忆能力确实得到了一些提升,但长期效果还有待验证。
在这过程中感慨良多,果然还是得靠日常实践去尝试,才能够发现技术细节上的问题并思考出解决方法。一切进步都建立在不断的试错中,如果不去试错,就永远无法进步。马克思曾说,人类的知识都来源于生产实践。唯有多做,才能进步。
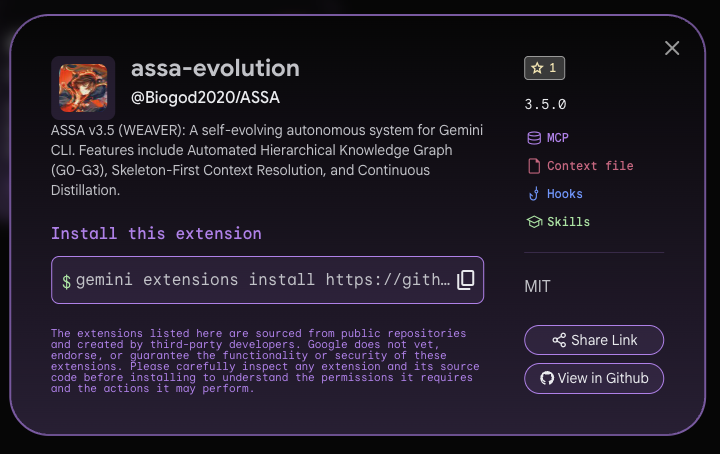
整个过程的思路让 AI 总结了一下,放在下面,欢迎大家阅读或体验我开发的插件(虽然目前只有我一个人 star)。
🚀 插件快捷入口
安装命令:
gemini extensions install https://github.com/Biogod2020/ASSA
[!IMPORTANT] 局限性说明:当然,当前的扩展也存在问题。在和别的工具混合使用的时候,记忆功能常常不能自行启动;且当上下文一长,钩子注入的功能似乎也会削弱。
后期可能考虑使用更加底层的代码逻辑,确保每次对话都能够稳定提交记忆。但是当前开发时间太少,在长上下文的时候手动驱动一下也不是不行,同时也坐等谷歌更新,给出更加底层、更加好用的钩子。也欢迎大家提出宝贵的意见!
01. 进化时间轴:八天之火
在一周多的时间里,我们经历了一场“压缩进化”。从最初的纵向记忆构建,到最后的横向秩序重塑。
Day 1-2: 完全没有头绪的摸索
Python 脚本试错,最终改道 JS/TS 体系。
Day 3-4: 拥抱 MCP 与 Hook
解决指令漂移与执行黑盒,确立 L1-L2-L3 提炼路径。
Day 4: 解决保鲜期问题
引入 PENDING / PROCESSED 状态过滤,解决历史遗忘问题。
Day 5: 架构的预判
引入 Graph 组织形式,划分 G0-G3 知识层级。
Day 6: 拥抱子代理
减轻主进程压力,剥离 Distiller 与 Promoter 逻辑。
Day 6-8: 极致性能与治理
实施 Index-First 策略,确立主进程主权。
02. 完全没有头绪的摸索 (Day 1-2)
最开始开发的时候,真的是完全没有头绪的摸索。
我先让 AI 用 Python 写了一个初版,尝试通过简单的脚本去拦截和记录对话。但这马上就暴露出问题:Python 脚本需要额外安装依赖(比如每次都要 pip install),而且与 Geminicli 原生基于 TypeScript/Node.js 的架构显得格格不入。在实际运行中,这种跨语言的调用导致环境非常不稳定,经常卡死。
在经历了最初两天的折腾后,我果断放弃了 Python 路线,决定遵循 Geminicli 的原生生态,全面改道 JS/TS。这是走向工程正规化的第一步,虽然推翻重来很痛苦,但这为后来的高性能 Hook 机制打下了基础。
03. 拥抱 MCP 与 Hook 机制,确立演进路径 (Day 3-4)
在改道 JS 之后,我开始仔细学习 Geminicli 里面给开发者留的工具。
我搞懂了什么是“钩子”(Hooks)——这就像是在 AI 思考前(BeforeAgent)和工具执行后(AfterTool)插上的**“眼线”**。我开始尝试用 MCP (Model Context Protocol) 工具来提炼日常的报错和纠偏信息。
在这个不断地讨论和尝试的过程中,我和 AI 共同总结出了一个非常有用的概念:L1-L2-L3 的知识提炼路径。
- L1 (Ledger):像账本一样记录原始的纠错信号和报错信息。
- L2 (Local):提炼成当前项目的开发习惯和特定模式。
- L3 (Global):晋升为跨项目的全局准则。
感觉这种层层递进的方式最符合人类开发者平时做总结的习惯,知识不再是一团乱麻,而是有了一条清晰的晋升通道。
物理标记 (Metadata)
不再只靠 AI 自己的语义记忆,而是通过 Hook 在每一次工具输出中强行注入物理标识。这建立了一个客观的坐标,确保它报告的成功是基于文件变动的真实情况。
语义情绪传感器 (Reflex)
利用 AI 对交互情绪的理解。当我纠偏错误或给予肯定(如“很好”、“不对”)时,系统会自动捕捉这些信号,并立即触发反馈流程,将当下的教训记录下来。
04. 解决知识的“保鲜期”问题 (Day 4)
随着交互的增加,我感觉单纯的累积事实肯定不行。日志文件变得越来越长,如果每次提炼都要读取所有的历史记录,Token 消耗和响应时间都会爆炸。
AI 提出了一些基于向量检索或摘要压缩的方法,但我感觉都不太好,过于复杂且容易丢失细节。
后来,我自己想出来了一个简单粗暴的方法:“过期/已处理”和“新鲜”的知识分类。我给 Ledger 里的每一条信号加上了状态标识。这样,AI 在执行提炼任务时,只用处理那些状态为 <span class="text-orange-500 font-bold text-sm">PENDING</span> 的“新鲜”知识,处理完立刻打上 <span class="text-green-500 font-bold text-sm">PROCESSED</span> 标签。这样效率瞬间高了很多,AI 的注意力也变得非常聚焦。
05. 架构的预判:Graph 与 G0-G3 层级 (Day 5)
即便解决了提炼效率,感觉文件里的规则仍然会越来越多。如果不从一开始就设计一个好的架构,未来根本没有办法自己整理。
为了方便快速索引和整理,结合之前在 Obsidian 等类似项目中积累的开发经验,我觉得用 Graph(网状图谱) 的形式会非常好,遂开始抛弃平铺的 Markdown 列表,转而使用相互链接的知识图谱。
同时,我感觉到知识不仅仅是一个扁平的 Graph,不同的规则在权重上也是有层级关系的。比如,不要乱删代码的优先级,肯定高于使用某种特定的命名规范。遂又将知识分为了 G0-G3 三个等级:
06. 拥抱子代理 (Subagents) (Day 6)
即使 Graph 的效果很好,但是让主进程的 Agent 既要写代码,又要负责维护设计一个聪明且智能的 Graph 笔记系统,感觉还是很大的工程量,上下文很容易就被撑爆。
在寻找优化方案时,我看到了 Superpowers 扩展里面各种基于 Subagents 的实现,并且发现 Geminicli 官方其实在底层是原生支持 Subagents 的。
所以,我就果断拥抱了 Subagents,将后台的提炼任务(Distiller)和全局规则同步任务(Promoter)打包成独立的子代理工具。这就像是给主 Agent 配备了两个后台秘书,大大降低了主进程的工程量,同时提高了系统的性能。
主进程与子代理分工
专注于执行用户任务,编写核心代码,并承担最终的架构治理决策。
在后台执行重型逻辑:将原始信号转化为 Patterns,并将其晋升至全局图谱。
07. 极致的优化与测试 (Day 6 - 至今)
实地测试和各种优化肯定是最麻烦的。为了应对由于注入规则过多导致的上下文膨胀(一度达到 25KB+),我实施了激进的“索引优先(Index-First)”策略,也就是所谓的 Skeleton-First (骨架优先) 解析。
系统不再一次性塞入所有规则的全文,而是只注入索引骨架,让 Agent 产生“前置阅读本能”,在需要动手修改前自己去 read_file。
同时,为了防止子代理在整理知识时擅作主张导致逻辑混乱,我确立了**“主进程主权”**:子代理只负责跑腿提炼和检测冲突,最终是否合并的意见,必须通过主进程来问询用户。
经历了反复的调试,最后系统迭代到了 3.5 版本,才能说比较容易使用了。
系统法典:不可动摇的原则
在测试过程中,我发现必须要给系统立几条规矩,不然 AI 很容易“偷懒”。我把这些叫做 G1 级工程标准,强制写在了它的系统提示词里:
结语:在实践中长出来的知识
马克思曾说,人类的知识都来源于生产实践。ASSA 的每一个功能节点,都不是预先设计的蓝图,而是在不断的试错、担忧和修正中,由我和 AI 一起**“磨”**出来的。
工程的真相往往就藏在那些最不起眼的失败里。当你开始认真对待 AI 的每一次“读错历史”,当你开始担心知识库会“越来越乱”,进化的种子就已经埋下了。Weaver 架构不是一个预设的蓝图,而是对进化阵痛的物理响应。
关于“长出来”的哲学
一开始我总是想预先设计一个完美的架构,比如一开始就想写一个大而全的 Python 框架。但事实证明,脱离了实际使用场景的设计都是空想。那些看起来很精妙的结构,往往在遇到真实的代码报错、Token 限制、或者工具执行超时的时候,瞬间土崩瓦解。
真正的迭代,是在每次痛苦的复制粘贴中,在每次忍无可忍的“为什么你又忘了”的怒吼中,逼着自己写下一个 Hook,加一个状态位,拆分一个 Subagent。这就是所谓的“实践出真知”。不要害怕一开始的代码有多乱,只要你还在写,在用,在痛,它就一定会长成它该有的样子。
通过这三个月的尝试,我不仅有了一个更好用的工具,更深刻体会到了在实践中不断前行的乐趣。虽然目前这个插件还很稚嫩,但这种从无到有的生长过程,对我而言就是最大的收获。